Compétence · SQL
Une base modélisée, 12 requêtes, zéro chiffre non vérifié
J'ai modélisé puis codé la base du projet en SQL : modèle conceptuel, modèle logique, 12 tables avec clés et contraintes, 5 vues analytiques et un dictionnaire de données. Chaque chiffre du site est recalculé en SQL et recoupé avec le classeur Excel : au moindre écart, la construction du site s'arrête.
- MCD / MLD (Merise)
- 3e forme normale
- CREATE TABLE / VIEW
- Clés et contraintes CHECK
- LAG / ROW_NUMBER / RANK
- PARTITION BY
- CTE (WITH)
- Pivot par agrégation conditionnelle
- Contrôle qualité
- Index et plan d'exécution
- PostgreSQL
Télécharger la base SQLite ↗Script SQL completLes 12 requêtes
Modélisation
Du modèle conceptuel à la base
J'ai modélisé les données avant de les coder : un modèle conceptuel (Merise) pour les objets et leurs liens, puis un modèle logique relationnel. Le modèle logique est dessiné à partir de la base elle-même, et le modèle conceptuel est confronté à la base à chaque construction : ils ne peuvent pas diverger du code.
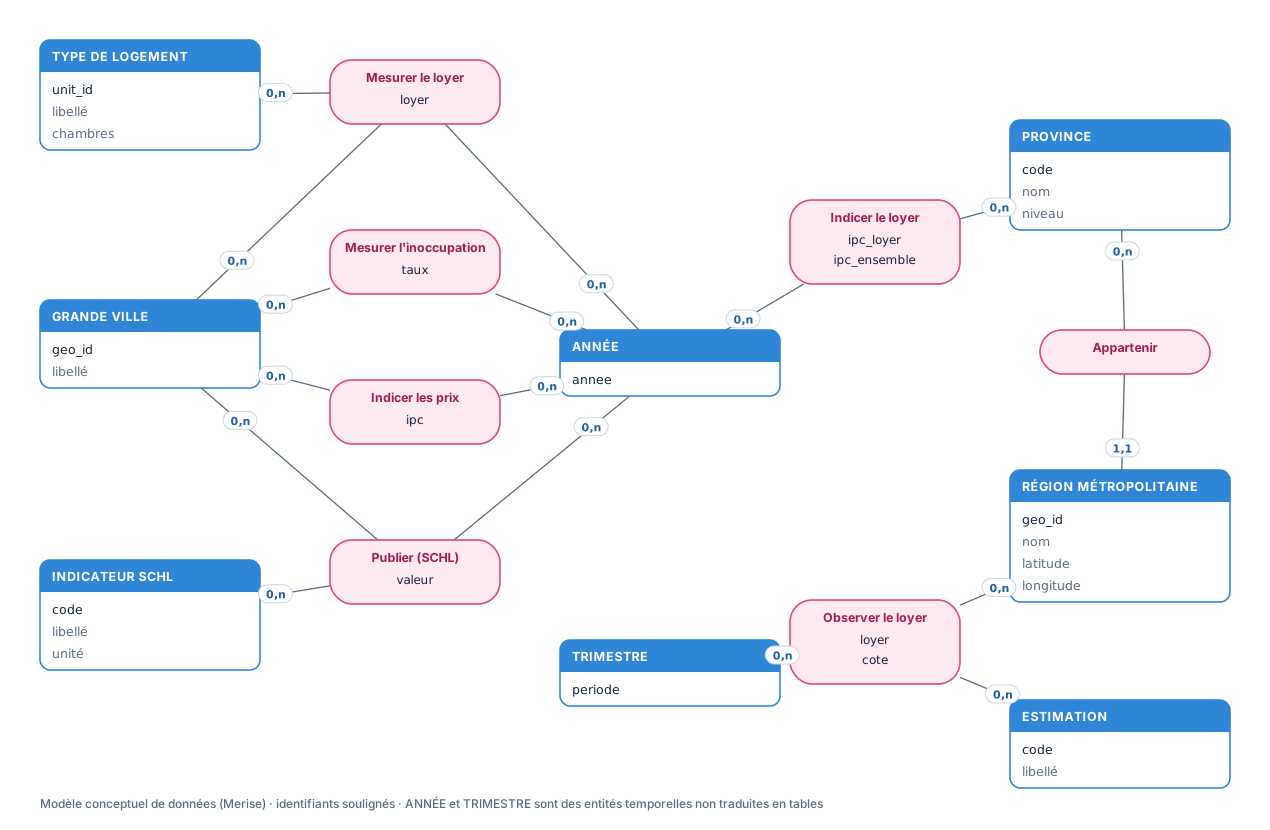
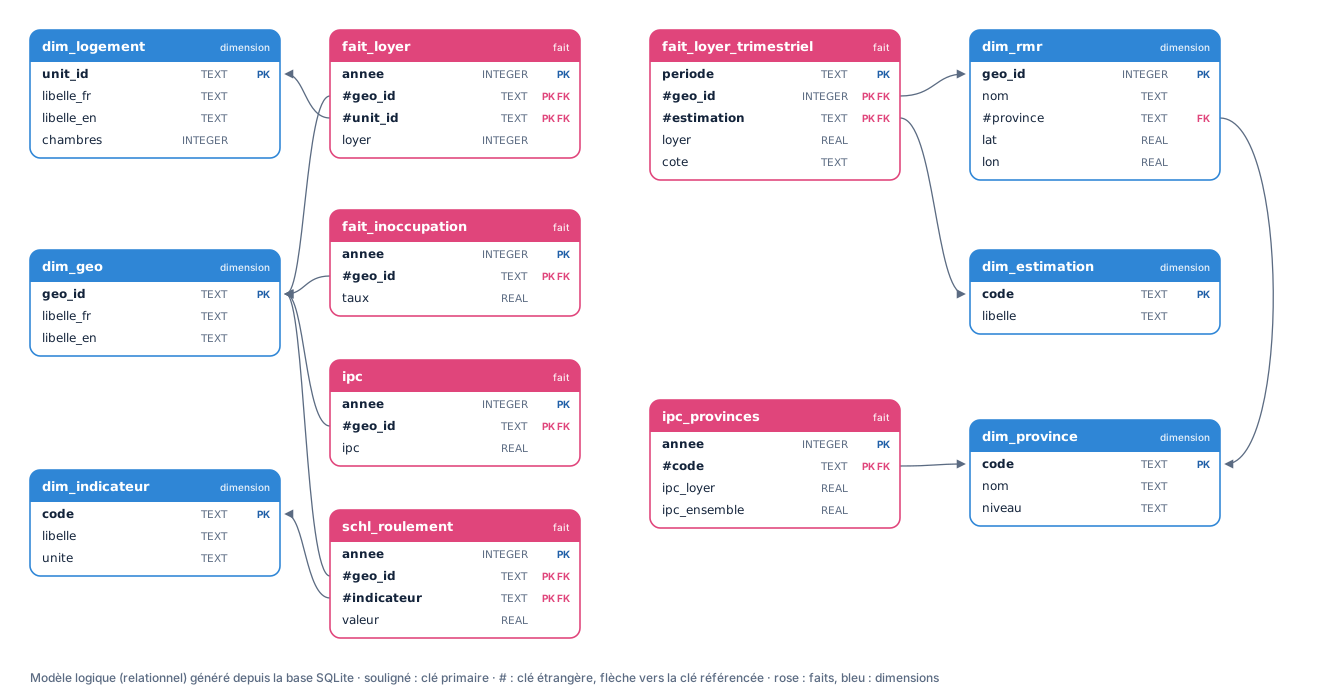
Choix de modélisation
- Troisième forme normale : l'unité d'un indicateur SCHL dépend de l'indicateur seul ; elle vit dans
dim_indicateur, pas dans la table de faits. - Dimensions de référence : provinces et types d'estimation sont des tables, avec clés étrangères, plutôt que des codes libres.
- Grain explicite : chaque table de faits a une clé primaire composée et un commentaire qui décrit une ligne.
Limite assumée
- « Grande ville » (séries SCHL depuis 1992) et « Région métropolitaine » (estimations trimestrielles) viennent de deux référentiels de Statistique Canada aux identifiants différents. Une table de correspondance serait l'étape suivante.
Fichiers à télécharger
- loyers.sqlitela base prête à ouvrir dans DB Browser for SQLite ou DBeaver · 188 Ko
- loyers.sqltables, vues et données en un seul script SQLite · 69 Ko
- requetes_loyers_montreal.sqlles 12 requêtes, du niveau débutant au niveau avancé · 10 Ko
- loyers_postgres.sqlla même base pour PostgreSQL · 43 Ko
- dictionnaire_donnees.csvchaque colonne de chaque table et vue · 6 Ko
Volumes : 306 loyers annuels, 298 loyers trimestriels (43 régions), 198 taux d'inoccupation, 111 valeurs d'IPC, 10 indicateurs SCHL.
Le schéma, en SQL
La base est reconstruite à chaque exécution à partir de ces deux scripts, puis contrôlée : PRAGMA foreign_key_check doit être vide et chaque contrainte CHECK rejette les valeurs impossibles avant qu'elles n'atteignent une analyse.
Script de création des 12 tables (sql/schema/01_tables.sql)
-- =====================================================================
-- Base de données « Loyers à Montréal » : modèle en étoile
-- Moteur : SQLite (compatible PostgreSQL / DuckDB avec ajustements mineurs)
-- Grain de chaque table de faits indiqué en commentaire.
-- =====================================================================
PRAGMA foreign_keys = ON;

-- ---------------------------------------------------------------- dimensions
CREATE TABLE dim_logement (
  unit_id     TEXT    PRIMARY KEY,                       -- studio, 1ch, 2ch, 3ch
  libelle_fr  TEXT    NOT NULL UNIQUE,
  libelle_en  TEXT    NOT NULL,
  chambres    INTEGER NOT NULL CHECK (chambres BETWEEN 0 AND 3)
);

CREATE TABLE dim_geo (                                   -- six grandes RMR (séries annuelles SCHL)
  geo_id      TEXT PRIMARY KEY,
  libelle_fr  TEXT NOT NULL,
  libelle_en  TEXT NOT NULL
);

CREATE TABLE dim_province (                              -- 10 provinces, 3 territoires et le Canada (agrégat)
  code        TEXT PRIMARY KEY CHECK (length(code) = 2),
  nom         TEXT NOT NULL UNIQUE,
  niveau      TEXT NOT NULL CHECK (niveau IN ('province', 'territoire', 'pays'))
);

CREATE TABLE dim_estimation (                            -- type d'estimation du tableau 46-10-0092
  code        TEXT PRIMARY KEY CHECK (code IN ('A', 'P')),
  libelle     TEXT NOT NULL UNIQUE                       -- A = loyer demandé, P = loyer payé
);

CREATE TABLE dim_indicateur (                            -- indicateurs du rapport SCHL ; l'unité dépend de l'indicateur seul (3FN)
  code        TEXT PRIMARY KEY,
  libelle     TEXT NOT NULL,
  unite       TEXT NOT NULL CHECK (unite IN ('dollars', 'pct'))
);

CREATE TABLE dim_rmr (                                   -- 42 RMR du tableau 46-10-0092 (+ ensemble)
  geo_id      INTEGER PRIMARY KEY,
  nom         TEXT    NOT NULL,
  province    TEXT    NOT NULL REFERENCES dim_province (code),
  lat         REAL    CHECK (lat IS NULL OR lat BETWEEN 41 AND 84),
  lon         REAL    CHECK (lon IS NULL OR lon BETWEEN -142 AND -52)
);

-- ---------------------------------------------------------------- faits
-- Grain : une année × une RMR × un type de logement (loyer moyen d'octobre, $ courants)
CREATE TABLE fait_loyer (
  annee    INTEGER NOT NULL CHECK (annee BETWEEN 1987 AND 2100),
  geo_id   TEXT    NOT NULL REFERENCES dim_geo (geo_id),
  unit_id  TEXT    NOT NULL REFERENCES dim_logement (unit_id),
  loyer    INTEGER NOT NULL CHECK (loyer > 0),
  PRIMARY KEY (annee, geo_id, unit_id)
);

-- Grain : une année × une RMR (taux d'inoccupation, immeubles de 6 logements et plus, %)
CREATE TABLE fait_inoccupation (
  annee   INTEGER NOT NULL,
  geo_id  TEXT    NOT NULL REFERENCES dim_geo (geo_id),
  taux    REAL    NOT NULL CHECK (taux BETWEEN 0 AND 100),
  PRIMARY KEY (annee, geo_id)
);

-- Grain : un trimestre × une RMR × une estimation (A = loyer demandé, P = loyer payé), 2 chambres
CREATE TABLE fait_loyer_trimestriel (
  periode     TEXT    NOT NULL CHECK (periode GLOB '[0-9][0-9][0-9][0-9]-[0-1][0-9]'),
  geo_id      INTEGER NOT NULL REFERENCES dim_rmr (geo_id),
  estimation  TEXT    NOT NULL REFERENCES dim_estimation (code),
  loyer       REAL    CHECK (loyer IS NULL OR loyer > 0),  -- NULL = non publié par Statistique Canada
  cote        TEXT    CHECK (cote IS NULL OR cote IN ('E', 'F', '..')),
  PRIMARY KEY (periode, geo_id, estimation)
);

-- Grain : une année × une grande ville (IPC d'ensemble, moyenne annuelle, 2002 = 100 ; Montréal)
CREATE TABLE ipc (
  annee   INTEGER NOT NULL,
  geo_id  TEXT    NOT NULL REFERENCES dim_geo (geo_id),
  ipc     REAL    NOT NULL CHECK (ipc > 0),
  PRIMARY KEY (annee, geo_id)
);

-- Grain : une année × une province (IPC du loyer et IPC d'ensemble, 2002 = 100)
CREATE TABLE ipc_provinces (
  annee         INTEGER NOT NULL,
  code          TEXT    NOT NULL REFERENCES dim_province (code),
  ipc_loyer     REAL    NOT NULL CHECK (ipc_loyer > 0),
  ipc_ensemble  REAL    NOT NULL CHECK (ipc_ensemble > 0),
  PRIMARY KEY (annee, code)
);

-- Grain : une année × une grande ville × un indicateur publié dans le rapport SCHL 2025
CREATE TABLE schl_roulement (
  annee       INTEGER NOT NULL,
  geo_id      TEXT    NOT NULL REFERENCES dim_geo (geo_id),
  indicateur  TEXT    NOT NULL REFERENCES dim_indicateur (code),
  valeur      REAL    NOT NULL,
  PRIMARY KEY (annee, geo_id, indicateur)
);

-- ---------------------------------------------------------------- index
CREATE INDEX ix_loyer_geo_unit     ON fait_loyer (geo_id, unit_id, annee);
CREATE INDEX ix_trim_geo_est       ON fait_loyer_trimestriel (geo_id, estimation, periode);
CREATE INDEX ix_rmr_province       ON dim_rmr (province);
CREATE INDEX ix_ipcp_code          ON ipc_provinces (code, annee);
Les 5 vues analytiques (sql/schema/02_vues.sql)
-- =====================================================================
-- Vues analytiques : la logique métier vit dans la base, pas dans chaque requête
-- =====================================================================

-- Loyers de Montréal en dollars constants de la dernière année disponible
CREATE VIEW v_loyer_reel AS
WITH ref AS (SELECT annee AS annee_ref, ipc AS ipc_ref FROM ipc WHERE geo_id = 'Montreal' ORDER BY annee DESC LIMIT 1)
SELECT f.annee, f.unit_id, l.libelle_fr AS logement, f.loyer AS loyer_nominal,
       ROUND(f.loyer * r.ipc_ref / i.ipc, 0) AS loyer_reel, r.annee_ref
FROM fait_loyer f
JOIN dim_logement l ON l.unit_id = f.unit_id
JOIN ipc i          ON i.annee = f.annee AND i.geo_id = f.geo_id
CROSS JOIN ref r
WHERE f.geo_id = 'Montreal';

-- Variation annuelle de chaque série (ville × type de logement)
CREATE VIEW v_variation_annuelle AS
SELECT annee, geo_id, unit_id, loyer,
       LAG(loyer) OVER w                                      AS loyer_prec,
       ROUND(100.0 * (loyer - LAG(loyer) OVER w) / LAG(loyer) OVER w, 1) AS variation_pct
FROM fait_loyer
WINDOW w AS (PARTITION BY geo_id, unit_id ORDER BY annee);

-- Dernier trimestre publié de chaque série (région × estimation)
CREATE VIEW v_dernier_trimestre AS
SELECT geo_id, estimation, periode, loyer, cote
FROM (
  SELECT t.*, ROW_NUMBER() OVER (PARTITION BY geo_id, estimation ORDER BY periode DESC) AS rn
  FROM fait_loyer_trimestriel t
  WHERE loyer IS NOT NULL
)
WHERE rn = 1;

-- Écart entre loyer demandé et loyer payé, par région
CREATE VIEW v_ecart_demande_paye AS
SELECT r.geo_id, r.nom, r.province,
       MAX(CASE WHEN d.estimation = 'A' THEN d.loyer END) AS demande,
       MAX(CASE WHEN d.estimation = 'P' THEN d.loyer END) AS paye,
       MAX(CASE WHEN d.estimation = 'A' THEN d.periode END) AS periode
FROM v_dernier_trimestre d
JOIN dim_rmr r ON r.geo_id = d.geo_id
GROUP BY r.geo_id, r.nom, r.province;

-- Hausse des loyers (IPC du loyer) par province et par année
CREATE VIEW v_ipc_provinces_variation AS
SELECT i.annee, i.code, p.nom AS province, i.ipc_loyer, i.ipc_ensemble,
       ROUND(100.0 * (i.ipc_loyer / LAG(i.ipc_loyer) OVER w - 1), 1)       AS hausse_loyer_pct,
       ROUND(100.0 * (i.ipc_ensemble / LAG(i.ipc_ensemble) OVER w - 1), 1) AS inflation_pct
FROM ipc_provinces i
JOIN dim_province p ON p.code = i.code
WINDOW w AS (PARTITION BY i.code ORDER BY i.annee);
Dictionnaire de données
Chaque colonne de chaque table et vue, avec son type, sa clé, sa définition et sa source. Le même dictionnaire est une feuille du classeur Excel.
Console : exécute les requêtes toi-même
SQLite tourne dans ton navigateur (sql.js). Choisis une requête, modifie-la ou écris la tienne, puis exécute-la. Raccourci : Ctrl+Entrée.
Les requêtes, une par une
Pour chaque requête : la question posée, les techniques utilisées, le code et le résultat.
Chaque requête porte son niveau : Débutant agrégats, jointures et règles de trois · Intermédiaire CTE, pivots, classements · Avancé fonctions de fenêtre (LAG, ROW_NUMBER, cadres ROWS).
Avancé · moteur
Lire un plan d'exécution, et porter la base sur PostgreSQL
Deux gestes qu'on attend d'un analyste qui écrit du SQL en entreprise : savoir pourquoi une requête est rapide, et savoir déplacer une base d'un moteur à un autre sans en changer le sens.
Avec et sans index : le même résultat, deux chemins
La requête lit la série d'une région (Montréal, loyer demandé). La clé primaire de la table commence par le trimestre : elle ne sert à rien pour filtrer sur la région. L'index ix_trim_geo_est commence par la région et l'estimation, puis le trimestre : le moteur va droit aux lignes, déjà dans l'ordre demandé.
SELECT periode, loyer
FROM fait_loyer_trimestriel
WHERE geo_id = 7 AND estimation = 'A'
ORDER BY periode DESC;
Avec l'index · EXPLAIN QUERY PLAN
SEARCH fait_loyer_trimestriel USING INDEX ix_trim_geo_est (geo_id=? AND estimation=?)
Sans l'index (DROP INDEX sur une copie de la base)
SCAN fait_loyer_trimestriel USING INDEX sqlite_autoindex_fait_loyer_trimestriel_1
Mesuré à la construction du site sur les 298 lignes de la table : 4 µs par exécution avec l'index, 12 µs sans (× 2,7). Sur une table de cette taille, l'écart est invisible à l'œil ; sur des millions de lignes, SEARCH contre SCAN fait la différence entre une seconde et une minute. L'index est défini dans le schéma :
CREATE INDEX ix_trim_geo_est ON fait_loyer_trimestriel (geo_id, estimation, periode);
La même base pour PostgreSQL
Le script loyers_postgres.sql (schéma, vues, données) est dérivé automatiquement des scripts SQLite du projet, pour que les deux versions ne divergent jamais, puis validé par la grammaire de PostgreSQL elle-même (pglast) : une erreur de syntaxe arrête la construction. Cinq écarts de dialecte, et seulement ceux-là :
PRAGMA foreign_keysretiré : les clés étrangères sont toujours actives dans PostgreSQL.GLOBremplacé par une expression régulière :periode ~ '^\d{4}-[01]\d$'.REALdevientDOUBLE PRECISION.ROUND(x, n)n'accepte qu'unnumeric:ROUND((x)::numeric, n)dans les vues.- Une sous-requête dans
FROMdoit porter un alias.
Télécharger loyers_postgres.sql
Chargement : createdb loyers && psql -d loyers -f loyers_postgres.sql. Le script est aussi dans le paquet de la base. Validation : syntaxe PostgreSQL complète ; l'exécution sur un serveur PostgreSQL n'a pas encore été faite dans ce projet.
Choix techniques
Pourquoi SQLite
- La base tient en un fichier versionné dans le dépôt et s'ouvre dans le navigateur, sans serveur.
- Les requêtes restent en SQL standard : elles tournent aussi sur DuckDB, PostgreSQL ou SQL Server avec des ajustements mineurs (POWER, concaténation).
Comment les résultats sont vérifiés
src/build_db.pyreconstruit la base, exécute les 12 fichierssql/*.sqlet compare les résultats clés aux indicateurs publiés sur le site, ainsi que deux requêtes entre elles.- Un écart (même de 0,05 point) interrompt la construction : aucun chiffre non vérifié ne peut être publié.